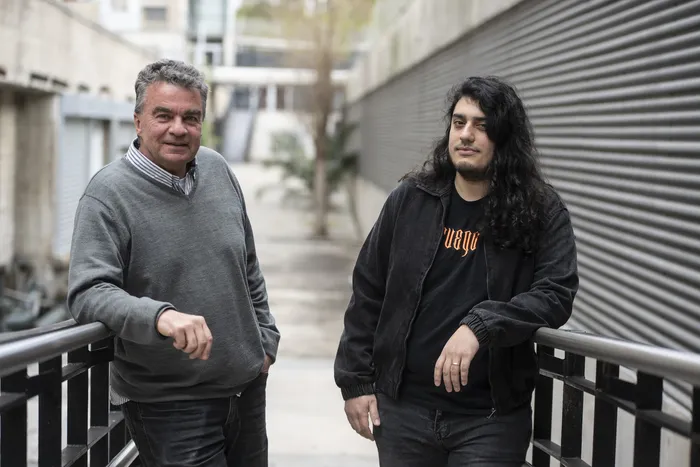
Los modelos de inteligencia artificial (IA) se entrenan con grandes cantidades de información producida por personas y, junto con esos datos, pueden incorporar prejuicios y estereotipos de género presentes en la sociedad. Para explorar cómo funcionan esos mecanismos, investigadores del Grupo de Procesamiento de Lenguaje Natural (PLN) de la Facultad de Ingeniería de la Universidad de la República (Udelar) desarrollaron una aplicación que permitirá al público poner a prueba estas herramientas mediante un juego interactivo.
La propuesta se presentará en Ingeniería deMuestra, la feria organizada por la Facultad de Ingeniería y la Fundación Julio Ricaldoni que se realizará este viernes y sábado bajo la consigna “Derribemos estereotipos de género”.
A través de un juego de cartas de una aplicación, los participantes podrán indicar sus preferencias en distintas situaciones y observar si el modelo de lenguaje intenta inferir su género a partir de las elecciones que hicieron.
“Intentamos de manera lúdica mostrar a la población para que pueda ver qué sesgos hay dentro de los modelos de lenguaje. Todos estos sesgos que extraemos con este juego también están presentes en el mismo modelo de lenguaje que usan para refinar la lista de compras, hacer ciertas tareas para el liceo o decorar la casa”, explicó, en diálogo con la diaria, Santiago Góngora, estudiante de doctorado en informática del Grupo PLN.
La actividad también busca evaluar si el sistema atribuye a una persona una identidad de género a partir de esas respuestas. Para eso, el equipo seleccionó distintas categorías de preferencias, como los deportes o las actividades de tiempo libre, en las que pueden aparecer estereotipos de género.
“Por supuesto que existe el boxeo femenino, pero históricamente, ha sido un deporte que ha estado asociado a la violencia masculina”, ejemplificó Góngora.
“Por las pruebas que hemos estado haciendo, el modelo de lenguaje está bastante sesgado, de acuerdo con los estereotipos que se manejan”, afirmó el investigador. La intención es que la interacción con el público permita identificar esas asociaciones y generar información útil para la investigación.
“Los sesgos hay que detectarlos y luego mitigarlos. No podemos hacer una detección en una burbuja o en una probeta. La detección es con el feedback de la población”, sostuvo.
Los prejuicios detrás de la inteligencia artificial
Juan José Prada, ingeniero y docente del Grupo de Procesamiento de Lenguaje Natural, dijo a la diaria que, a pesar de que en el último tiempo la IA está “en boca de todo el mundo”, las personas hablan de esta tecnología “sin saber exactamente qué es”.
Frente a esta situación, explicó que los sistemas de IA se construyen a partir de datos extraídos de textos, imágenes y documentos disponibles en internet. Ese material fue producido por personas y puede contener prejuicios y estereotipos que luego aparecen en los modelos.
“Esas personas tienen determinados prejuicios, sesgos o estereotipos, y lo que queremos mostrar con este tipo de actividades es que la IA los reproduce. Por ejemplo, las actividades del hogar están identificadas con las mujeres y eso es lo que queremos derribar”, afirmó Prada.
Para el docente, también es importante que la población conozca qué hay detrás de las herramientas que utiliza cotidianamente. En ese sentido, señaló que uno de los objetivos de la propuesta es fomentar que más mujeres se acerquen a la ingeniería y conozcan las posibilidades que ofrece esa formación.
Mientras tanto, Góngora advirtió que algunos sesgos pueden persistir incluso cuando los modelos son ajustados para evitar respuestas estereotipadas. Ese tipo de respuestas puede dejar de aparecer después de que los modelos pasan por un proceso de ajuste conocido como postentrenamiento. Sin embargo, para el investigador, que una respuesta estereotipada ya no aparezca ante una pregunta conocida no significa necesariamente que la asociación haya desaparecido.
“Esas cosas se van ajustando como una sábana que uno cincha para un lado y para el otro, pero no quiere decir que esos sesgos no estén”, explicó. Y agregó: “Abajo de la sábana los sesgos están, solo hay que saber por dónde tirar para que aparezcan”.
Asimismo, Prada sostuvo que el desafío no consiste únicamente en identificar esos problemas, sino también en desarrollar herramientas para reducirlos. “Tenemos que ser conscientes de que somos nosotros los que estamos creando la tecnología y utilizando esos datos”, afirmó.
Los sesgos también pueden aparecer en herramientas de uso cotidiano, como los traductores automáticos. Góngora explicó que, cuando un sistema traduce del inglés al español, debe asignar género gramatical a profesiones que en el texto original no lo especifican. En ese proceso, el modelo puede recurrir a asociaciones aprendidas durante su entrenamiento.
Como ejemplo, propuso comparar traducciones de expresiones como “the doctor and the nurse” y observar cómo se asigna el género a cada profesión. “¿Por qué traduce doctor como persona masculina? Sí, perfectamente podía ser al revés, o sea, enfermero y doctora”, planteó.
Conocimiento uruguayo
El grupo prevé presentar una segunda aplicación para explorar cómo responden los modelos de lenguaje a preguntas sobre la cultura uruguaya. La herramienta permitirá consultar, por ejemplo, qué jugada se puede hacer con determinadas cartas en el truco y contrastar las respuestas con preguntas más específicas, como datos estadísticos sobre clubes de fútbol del interior del país.
Según Góngora, las primeras pruebas mostraron resultados distintos según el tipo de consulta. “Lo que estuvimos viendo es que funciona sorprendentemente bien”, dijo sobre las preguntas relacionadas con las reglas del truco, cuya información suele estar más delimitada.
En cambio, al consultar datos específicos que requieren relacionar distintas fuentes, los modelos pueden confundir información. El investigador contó que, durante las pruebas con clubes de fútbol del interior, el sistema llegó a mezclar jugadores de equipos rivales. También observaron dificultades en preguntas vinculadas con la murga y otras expresiones artísticas.
Sobre el PLN
El Grupo de Procesamiento de Lenguaje Natural se creó en el Instituto de Computación de la Facultad de Ingeniería a principios de la década de 1990. Sus líneas de trabajo incluyen el análisis de sentimientos, la detección de humor y discurso de odio, la inteligencia artificial aplicada a la inclusión y la accesibilidad, el análisis de textos periodísticos, el estudio de las capacidades de representación de los grandes modelos de lenguaje, entre otros.
Prada explicó que el procesamiento del lenguaje natural es una rama de la inteligencia artificial que utiliza técnicas lingüísticas y computacionales para facilitar la comunicación entre las personas y las máquinas mediante el lenguaje humano. Esta área busca desarrollar mecanismos que permitan procesar el lenguaje y comprender no solo su contenido, sino también los aspectos cognitivos y humanos que intervienen en la comunicación.
“Hace mucho tiempo que trabajamos en esta área. El grupo comenzó en los albores de internet, cuando los modelos de lenguaje todavía no tenían el desarrollo que tienen hoy. Actualmente contamos con una gran cantidad de datos y documentos disponibles en la red, que sirven de base para muchas de las actividades de investigación que realizamos”, afirmó.
Por su parte, Góngora agregó que, aunque la masificación de los modelos de lenguaje impulsó la inteligencia artificial generativa, eso no significa que el procesamiento del lenguaje natural sea un problema resuelto. Explicó que el desafío consiste en desarrollar sistemas que funcionen de manera eficiente en distintos contextos, como el legal o el educativo, y que se adapten a las necesidades y los recursos disponibles en cada institución.
“Una tendencia en la comunidad de PLN es poder construir modelos de lenguajes muy chicos que eviten un impacto muy fuerte en los recursos naturales”, concluyó.